导出 ChatGPT 和 DeepSeek 对话,不必一条一条来。
一次导一段没问题,直到列表变长。Extry 会走完你的整段历史,把每段对话写进同一个压缩包:每段对话一个文件夹,另有一个索引页把它们列出来。
- index.html26.3 KB索引
- 001_pricing-model/pricing-model.md18.4 KBmarkdown
- 001_pricing-model/files/budget-q3.xlsx88.6 KB附件
- 002_api-migration/api-migration.md44.1 KBmarkdown
- 003_hiring-loop/hiring-loop.md12.7 KBmarkdown
- images.html14.2 KB图库
为什么
对话列表不是一套档案
它存在一个账号里,藏在登录之后,由一个服务决定历史保留多久、能往回翻多远。那里的东西,都不像你硬盘上的文件夹那样属于你。
导出把列表变成文件。grep 能搜,你本来就在做的备份会顺手带上,读的时候也不用登录到任何地方。
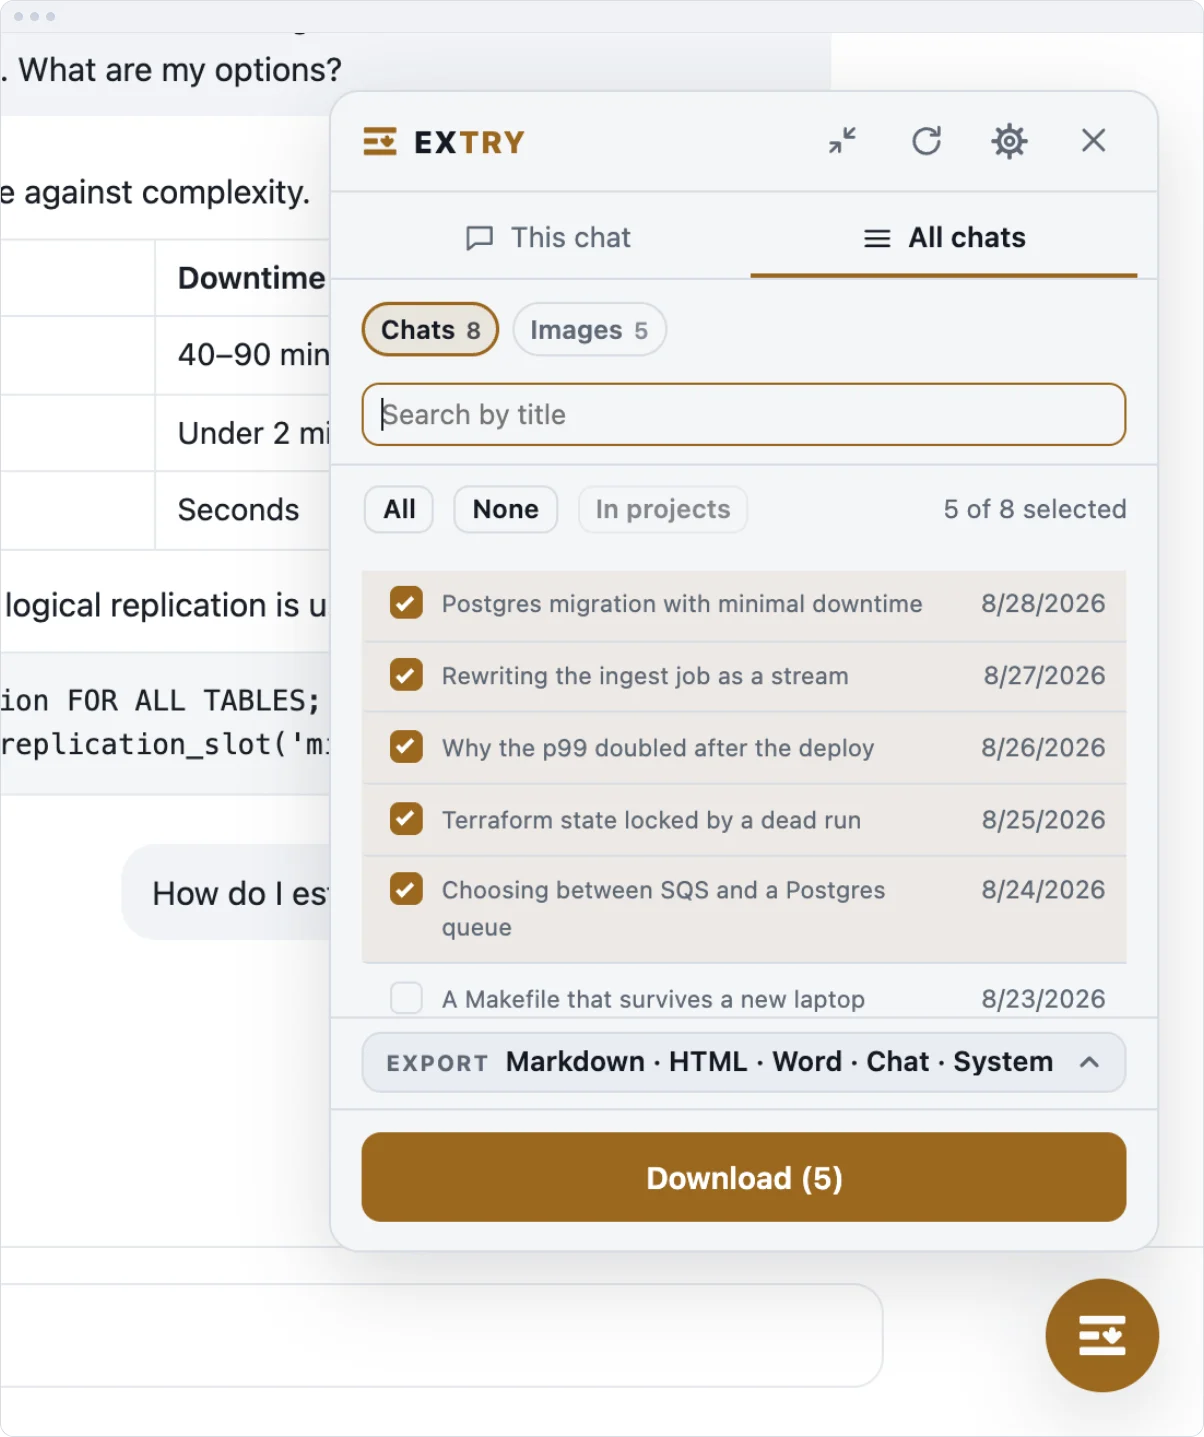
导出内容
一个压缩包,每段对话一个文件夹
每段对话都有自己的编号文件夹,以对话标题命名,里面是转录和当时的文件——而不是一份需要事后拆分的长文档。
压缩包根目录有一个 index.html,列着每段对话的日期、消息条数和用到的模型。这样这个包就有了入口,而不是一堵文件夹的墙。若某些对话含图片,它们还会汇总到一个图库页。
某段对话下载失败不会中断整个过程。它会出现在索引里并标注失败:缺口当场就看得见,不用等到几个月后。
如何操作
三步,一个压缩包
- 打开 ChatGPT 或 DeepSeek,点击页面上的 Extry 按钮。
- 在面板里选择需要的格式。
- 点击「全部对话」,勾选需要的(或全选),再点「下载」。
历史很长时需要几分钟:扩展会按列表一段一段处理,并显示进度。在 DeepSeek 上,最新一百段之外的列表来自页面自己的侧边栏,若侧边栏是收起的会先短暂展开。「暂停」会在两段对话之间停下,「停止」结束整个过程,并可保留已经导出的部分。列表会边读边出现,读取本身也可以随时停止,再从停下的地方继续。不需要账号,没有上传步骤。
处理位置
每一部分在哪里运行
| 内容 | 在哪里进行 |
|---|---|
| 导出为各种格式 | 在你的浏览器中 |
| 附件与图片 | 在你的浏览器中 |
| 对话内容 | 不发送到任何地方 |
| 使用统计 | 不收集 |
| 排版级 PDF (稍后推出,需自行开启) | 在服务器上,文件随后立即删除 |
常见问题
关于批量导出
必须一段一段导出吗?
不必。会先打开列表:勾选需要的对话(或全选),它们会一起导出成一个压缩包。
导出很久,中途能停下来吗?
可以。「暂停」在两段对话之间等待,随后从原处继续;「停止」结束整个过程,并询问是否保留已经导出的部分。保留下来的部分会在压缩包名字里标明。
压缩包里每段对话是分开的吗?
是。每段都有自己的编号文件夹,可以单独打开、移动或搜索。
附件会一起导出吗?
会。每个对话文件夹里都有自己的 files/ 文件夹,装着那段对话中的上传文件和生成的图片。
如果某段对话下载失败会怎样?
过程继续。失败的那段会连同原因列在索引页里,缺口是看得见的,而不是悄无声息。
需要账号吗?
使用不需要账号。扩展读取的是你已经打开的页面。